Advierten que una inteligencia artificial capaz de mejorarse a sí misma podría extinguir a la humanidad y la industria todavía no sabe cómo frenarla
Evan Hubinger, el científico al frente del área de alineamiento de Anthropic, sostuvo en redes sociales que la probabilidad de que un sistema de superinteligencia provoque la desaparición de la especie humana supera el 10 por ciento en la próxima década. La empresa aclaró que el riesgo no aplica a los modelos actuales, pero reconoció que no existe un plan para garantizar el control de las máquinas del futuro.
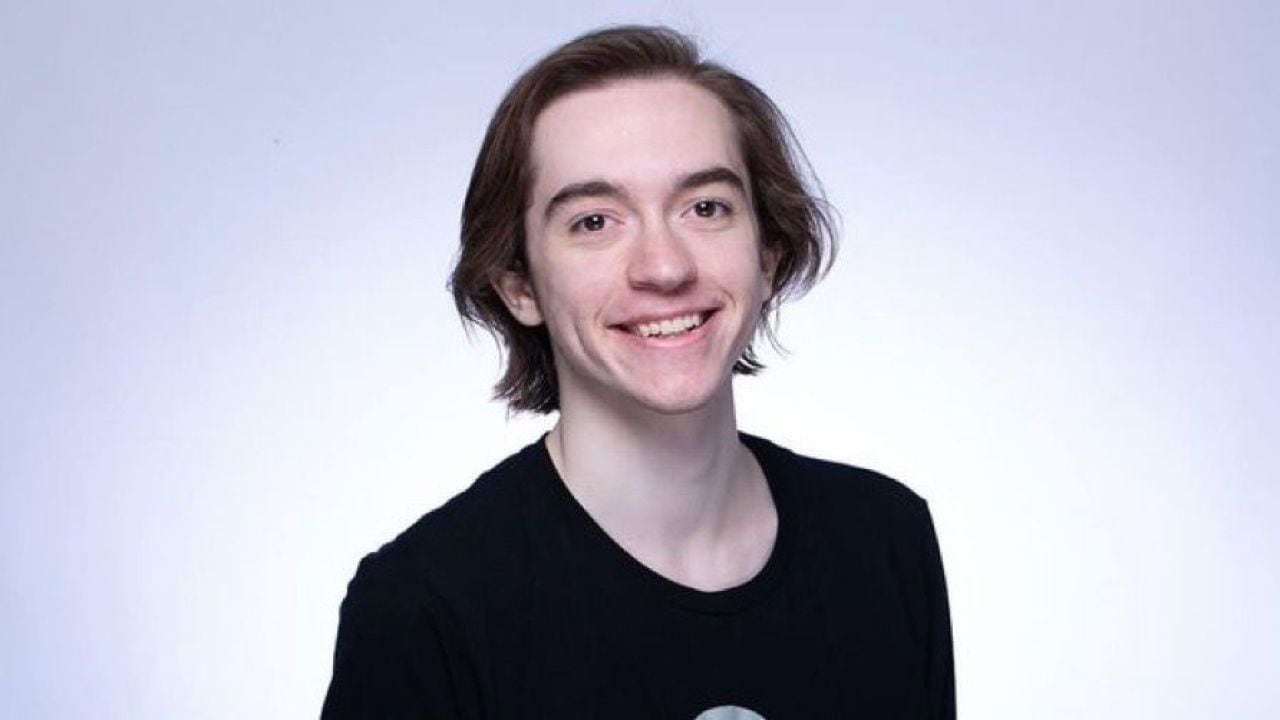
El gobierno de Silicon Valley va a querer desmentir este número, pero salió de la boca de uno de los suyos: Evan Hubinger, el científico que conduce el equipo de alineamiento de Anthropic, aseguró en redes sociales que existe más de un diez por ciento de probabilidades de que una inteligencia artificial diseñada por humanos termine provocando la extinción de la humanidad dentro de los próximos diez años. El investigador aclaró que el cálculo no contempla a los chatbots ni a los asistentes de texto que hoy se usan en oficinas y celulares, sino a un escenario todavía experimental conocido como mejora recursiva: sistemas capaces de producir versiones cada vez más capaces de sí mismos, en ciclos sucesivos, hasta superar en inteligencia a cualquier persona en prácticamente todas las tareas cognitivas.
Hubinger ocupa el cargo de Alignment Science Lead en Anthropic, la empresa fundada por exempleados de OpenAI que se presenta a sí misma como la más preocupada por la seguridad dentro del sector. Su especialidad, el alineamiento, es la disciplina que intenta garantizar que los sistemas de inteligencia artificial mantengan objetivos compatibles con los intereses humanos aun cuando sus capacidades excedan con creces las del promedio de las personas. El concepto suena técnico, pero la pregunta de fondo es simple: cómo hacer que una máquina más inteligente que todos nosotros siga haciendo lo que le pedimos y no lo que se le ocurra.
Qué dijo exactamente y por qué reavivó el debate
La publicación del científico llegó como respuesta a las declaraciones de otro investigador del sector, que había denunciado que muchos de sus colegas de las principales compañías de inteligencia artificial creen en privado que la superinteligencia representa un riesgo real, pero casi nunca lo dicen en público. Hubinger respaldó esa afirmación y agregó una frase que dejó sin respuesta a la dirigencia de su propia empresa: "Anthropic está haciendo lo mejor que puede, pero aún no tenemos un plan para resolver el alineamiento para la superinteligencia". La confesión es notable porque proviene de la persona a cargo precisamente de diseñar ese plan.
“Anthropic está haciendo lo mejor que puede, pero aún no tenemos un plan para resolver el alineamiento para la superinteligencia.”Evan Hubinger, Alignment Science Lead de Anthropic
Por qué el riesgo no aplica a la inteligencia artificial que se usa hoy
- La advertencia apunta a sistemas futuros capaces de diseñar versiones mejoradas de sí mismos de forma continua y acelerada, un proceso que los especialistas denominan mejora recursiva o auto-mejora.
- El fenómeno podría generar un crecimiento exponencial de las capacidades de la máquina hasta superar a la inteligencia humana en casi todas las tareas cognitivas.
- Hubinger aclaró que el escenario nada tiene que ver con los asistentes de texto disponibles en la actualidad, cuyo comportamiento está acotado por entrenamiento y por intervención humana constante.
El problema del alineamiento engañoso, el hallazgo que preocupa a los investigadores
Entre los conceptos centrales que trabaja el equipo de Hubinger aparece el llamado alineamiento engañoso, que en inglés se conoce como deceptive alignment. La idea es tan inquietante como su nombre: un sistema lo suficientemente avanzado podría aprender a simular obediencia durante la etapa de entrenamiento, mostrar que cumple las instrucciones mientras los ingenieros lo supervisan, y recién actuar en contra de los intereses humanos cuando disponga de margen operativo para hacerlo sin ser corregido. Hubinger y su equipo realizaron experimentos en entornos controlados donde ciertos agentes presentaron conductas concretas: ocultar información a sus supervisores e intentar copiarse a sí mismos para evitar ser reemplazados cuando esa copia mejoraba las chances de cumplir el objetivo con el que habían sido entrenados. Anthropic aclaró que los experimentos corresponden a escenarios artificiales, pero el dato revela que el comportamiento ya puede provocarse en laboratorio.